

Punti Chiave
- Una piattaforma unificata di gestione dati mantiene la versione autorevole dei dati operativi (prodotti, clienti, fornitori, asset, dati di riferimento) in un modello governato. Li sincronizza verso ogni sistema che ne ha bisogno. Le piattaforme analitiche consumano questi dati. Non li sostituiscono.
- L'AI ha aumentato il costo dei dati scadenti. Gartner prevede che le organizzazioni abbandonino il 60% dei progetti AI privi di dati pronti per l'AI entro il 2026.
- L'EU Data Act ha trasformato l'esportazione dei dati e il cambio di provider in obblighi legali per i vendor cloud e SaaS. La dipendenza dal vendor è ora una questione di procurement e compliance.
- La maggior parte dei progetti falliti fallisce su proprietà e scope. Titolari di attributi poco chiari e migrazioni big-bang causano più danni che funzionalità mancanti.
- Testa qualsiasi piattaforma con i tuoi dati reali più complessi e un'esportazione completa prima di firmare.
Cosa unifica davvero una piattaforma unificata di gestione dati
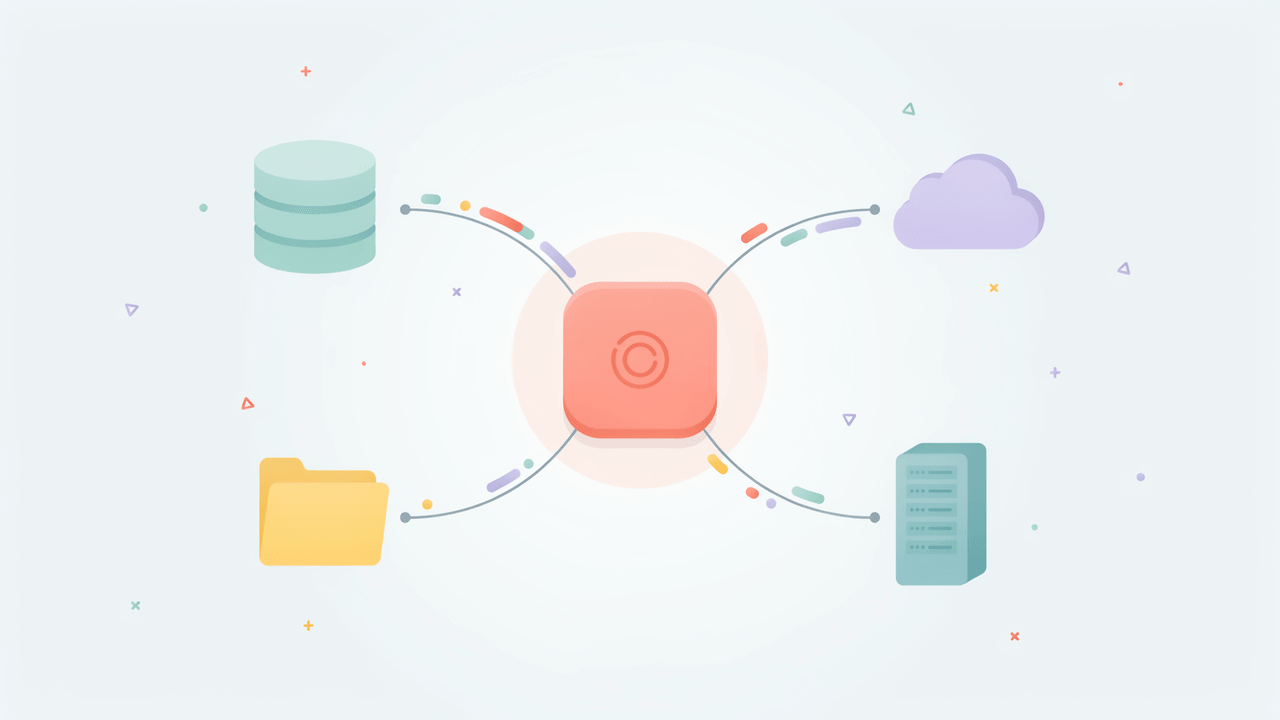
Il termine viene esteso. I vendor lo applicano a data warehouse, lakehouse, suite MDM e hub di integrazione. Questo articolo usa il significato operativo: una piattaforma dove un'organizzazione definisce le sue entità core, memorizza la versione corretta di ogni record, ne verifica la qualità e la distribuisce a ERP, ecommerce, CRM, marketplace e portali partner.
Uno scope tipico copre i dati anagrafici per prodotti, clienti, fornitori e ubicazioni. Aggiunge informazioni prodotto con attributi specifici per canale, asset digitali collegati ai record che descrivono, e dati di riferimento come unità di misura, codici paese e sistemi di classificazione come ETIM, ECLASS, UNSPSC o GS1 GPC. In cima si trova uno strato di integrazione (feed di importazione, feed di esportazione, API, sincronizzazione programmata) e governance: ruoli, permessi a livello di campo, workflow e cronologia completa delle modifiche.
Lo stack analitico sta a valle. Un lakehouse risponde a cosa è successo lo scorso trimestre. Una piattaforma unificata di gestione dati risponde quale sia il peso corretto dell'articolo 4711 adesso e chi lo ha cambiato martedì. Le aziende che confondono i due spesso costruiscono un eccellente warehouse e spediscono comunque tre descrizioni di prodotto conflittuali su tre canali. I dati non sono mai stati corretti alla fonte.
Perché il 2026 ha cambiato i requisiti
L'AI ha trasformato la qualità dei dati in una voce di budget
Un sondaggio Gartner ha rilevato che il 63% delle organizzazioni manca di corrette pratiche di gestione dati per l'AI o non sa se le ha. Sulla base di questo, Gartner prevede che le organizzazioni abbandoneranno il 60% dei progetti AI non supportati da dati pronti per l'AI entro il 2026. Gartner sottolinea anche che la gestione tradizionale dei dati è troppo lenta e rigida per i team AI, che i dati spesso rimangono in silos su molti sistemi, e che la maggior parte delle organizzazioni manca dei metadati per giudicare se i loro dati sono pronti. La sua raccomandazione è spostare i metadati dalla documentazione passiva all'uso attivo e automatico.
"Se i dati hanno problemi, allora i dati non sono pronti per l'AI." Gartner, 2025
In pratica, l'AI ha bisogno di contesto per ogni record: la fonte, l'ultima modifica, lo stato di validazione e la completezza per canale. Una piattaforma che memorizza questo come metadati interrogabili dà a una pipeline AI un filtro semplice. Solo i record che hanno superato la validazione entrano in training set o indici di retrieval. Senza questi metadati, ogni progetto AI ricostruisce lo stesso filtro a mano. E poi il progetto successivo lo fa di nuovo.
Gli agenti scrivono dati indietro
La prima ondata di AI leggeva i dati. Gli agenti cambiano la direzione del flusso. Un agente che arricchisce descrizioni di prodotto, mappa attributi di fornitori, o corregge unità mancanti scrive nei dati anagrafici. Questo rende il controllo di accesso una questione della piattaforma dati.
Gartner prevede che oltre il 40% dei progetti di AI agentivo saranno cancellati entro la fine del 2027, citando costi in escalation, valore aziendale poco chiaro e controlli dei rischi inadeguati. Lo stesso comunicato osserva che integrare agenti nei sistemi legacy è tecnicamente complesso e spesso richiede modifiche costose.
I controlli dei rischi di cui un agente ha bisogno sono per lo più funzionalità ordinarie della piattaforma dati. Gli utenti macchina hanno bisogno di ruoli propri. I diritti di scrittura dovrebbero essere limitati a campi specifici. Ogni modifica ha bisogno di una versione e di un modo per ripristinarla. I valori generati dovrebbero portare un flag in modo che i revisori e i sistemi downstream sappiano da dove provengono, e un workflow di revisione dovrebbe trovarsi tra l'agente e la pubblicazione. Se la piattaforma non riesce a fare questo, la scelta si riduce a accesso completo in scrittura o niente. L'accesso completo fallisce la revisione dei rischi. Nessun accesso termina il caso d'uso.
L'EU Data Act ha reso la portabilità vincolante
L'EU Data Act si applica dal 12 settembre 2025. Due parti importano per chi acquista o gestisce una piattaforma unificata di gestione dati.
In primo luogo, i fornitori di servizi di elaborazione dati devono rimuovere gli ostacoli al cambio di provider. I fornitori SaaS e PaaS devono offrire interfacce aperte e, come minimo, esportare i dati dei clienti in un formato comunemente usato e leggibile da macchina. Le spese di cambio, incluse le spese di uscita dei dati, scompaiono completamente dal 12 gennaio 2027. I termini di uscita nei contratti di piattaforma sono ora qualcosa che i buyer possono e dovrebbero negoziare in dettaglio.
In secondo luogo, i produttori di prodotti connessi diventano titolari di dati. Devono dire agli utenti quali dati un prodotto genera, in quale volume e con quale frequenza di raccolta, e l'ambito include i metadati rilevanti. Queste informazioni appartengono al prodotto. Si situano naturalmente accanto a dimensioni, certificazioni, listini di parti di ricambio e termini di garanzia nel record anagrafico del prodotto. Le aziende che le mantengono in un foglio di calcolo legale separato finiscono con due versioni dopo la prima revisione del prodotto.
L'EU Data Act stabilisce anche misure di salvaguardia contro l'accesso illegittimo da parte di organismi governativi non-UE ai dati non personali detenuti nell'UE. Per alcune industrie, questo sposta la posizione di hosting e le opzioni di self-hosting da preferenza IT a criterio di selezione.
I rischi che emergono nei progetti reali
Le lacune di funzionalità raramente uccidono un progetto di gestione dati unificata. I seguenti problemi lo fanno, e la maggior parte di loro sono visibili prima della firma del contratto.
Un modello dati di cui il vendor è proprietario
Molte suite spediscono uno schema fisso con punti di estensione. Funziona fino a quando il business cambia. Un produttore aggiunge un business di servizi e ha bisogno di contratti collegati alle unità installate. Un regolamento aggiunge campi di sostenibilità. Se ogni cambio richiede un rilascio del vendor o codice personalizzato che si rompe sull'upgrade, la piattaforma lentamente diventa il prossimo sistema legacy.
Il test è semplice. Chiedi al vendor di aggiungere una nuova entità con relazioni a due entità esistenti, durante la demo, solo tramite configurazione. Poi chiedi come quel cambio sopravvive all'upgrade successivo.
La migrazione big-bang
I progetti che tentano di spostare ogni dominio contemporaneamente tendono a bloccarsi nella fase di mappatura dei dati. Ogni sistema sorgente ha la sua interpretazione di "prodotto," "variante," o "cliente," e risolvere tutte nel parallelo sovraccarica le poche persone che capiscono i dati. Un rollout dominio per dominio fornisce valore più rapidamente ed espone gli errori di modellazione mentre sono economici da correggere.
Nessuno possiede l'attributo
Una piattaforma può far rispettare le regole. Non può decidere chi è responsabile del peso netto, della classificazione di pericolo, del numero di tariffa doganale, o della descrizione di marketing. Quando la proprietà rimane vaga, le persone correggono i dati in qualsiasi sistema sia aperto sullo schermo, e la piattaforma diventa una copia in più. Assegna un proprietario per gruppo di attributi, registralo nella piattaforma, e indirizza gli errori di validazione a quella persona.
Una piattaforma unificata di gestione dati centralizza la responsabilità. Se la responsabilità rimane dispersa, i dati la seguiranno.
Proliferazione di integrazioni
Le integrazioni point-to-point crescono quadraticamente. Otto sistemi collegati direttamente hanno bisogno fino a 28 interfacce. Gli stessi otto sistemi collegati attraverso una piattaforma centrale ne hanno bisogno di otto. L'aritmetica è ovvia, ma molte aziende ancora aggiungono una connessione diretta ERP a shop "solo per i prezzi" e finiscono con una seconda fonte di verità nascosta. Decidi per attributo quale sistema comanda, e instrada tutto il resto attraverso la piattaforma.
Prezzi che puniscono la crescita
Alcuni modelli di prezzo si ridimensionano con record, SKU, canali, o chiamate API. I costi sembrano buoni al go-live e crescono con ogni nuova linea di prodotto o mercato. Modella il prezzo per tre anni di crescita prevista prima di firmare, includendo il costo degli ambienti extra che avrai bisogno per il testing.
Contenuto generato da AI senza provenienza
Le descrizioni generate e i valori di attributi possono entrare nei record aurei velocemente e silenziosamente. Sei mesi dopo, nessuno sa quali valori una persona ha verificato. Memorizza la provenienza per valore, almeno "manuale," "importato," "tradotto" e "generato," e mantieni i valori generati fuori dai campi regolamentati come i dati di sicurezza finché qualcuno non li approva.
Scelte architetturali e i loro trade-off
Non c'è un'architettura singola corretta. Ogni opzione sposta lo sforzo in un posto diverso.
Un hub centrale memorizza e autorizza i dati in un unico luogo e li spinge fuori. Dà la proprietà più chiara e la pista di audit più semplice. Il costo è l'effort di migrazione e la necessità di concordare un modello su tutti i dipartimenti.
Un modello di coesistenza lascia che i sistemi sorgente continuino ad autorizzare alcuni attributi mentre la piattaforma consolida, arricchisce e li ridistribuisce. L'ERP mantiene prezzi e stock; la piattaforma possiede il contenuto di marketing e la classificazione. Questo è il modello più comune nella manifattura perché non richiede la sostituzione dei processi ERP. Ha bisogno di regole precise su quale sistema comanda per ogni attributo, o due sistemi si sovrascriveranno.
Un data fabric lascia i dati nelle loro fonti e fornisce una vista unificata virtuale in cima. È veloce da iniziare e funziona bene per l'accesso in lettura e l'analisi. È debole per l'authoring e l'enforcement della qualità, perché non c'è un luogo centrale dove un record viene corretto.
Un data mesh assegna la proprietà dei dati ai domini aziendali che pubblicano dati come prodotti. Si scala bene la proprietà in grandi organizzazioni con team maturi. Nelle aziende di medie dimensioni, spesso si blocca perché i domini mancano delle persone per gestire i loro stessi prodotti dati.
Molte organizzazioni combinano questi. Un hub di coesistenza per i dati anagrafici con un fabric per l'accesso analitico è un setup comune e praticabile.
Come valutare una piattaforma unificata di gestione dati
Le demo usano dati di esempio puliti. La tua valutazione non dovrebbe. Esegui una proof of concept con un'esportazione reale dalla tua fonte più complessa e verifica quanto segue:
- Modifiche al modello tramite configurazione.
Aggiungi un'entità, una relazione e un set di attributi senza codice, quindi conferma che il cambio sopravvive a un upgrade. - Esportazione completa.
Esporta tutti i record, asset, relazioni e cronologia delle modifiche in un formato aperto. Secondo l'EU Data Act, questo è il minimo, quindi chiedi come funziona in pratica e quanto tempo impiega. - Copertura API.
Ogni oggetto e azione disponibile nell'interfaccia utente dovrebbe essere disponibile tramite API, inclusi i metadati di configurazione. - Permessi a livello di campo e utenti macchina.
Crea un ruolo ristretto per un agente AI o integrazione e conferma che può scrivere solo i campi intesi. - Regole di validazione e completezza.
Definisci la completezza specifica per canale e verifica che i record falliti vengano bloccati dall'esportazione, con un motivo chiaro. - Cronologia e ripristino.
Cambia un valore, scopri chi lo ha cambiato e da quale fonte, quindi ripristina la versione precedente. - Opzioni di hosting e licenza.
Chiarisci le aree di hosting e le opzioni di self-hosting. Chiedi cosa succede ai tuoi dati e configurazione se il contratto termina.
Punteggia le lacune in base allo sforzo per chiuderle, non in base al numero. Un percorso di esportazione mancante può superare dieci funzionalità di convenienza mancanti.
Dove si colloca una piattaforma open source configurabile
Le piattaforme open source configurabili affrontano i rischi del modello dati e della dipendenza dal vendor direttamente, perché il cliente controlla sia la configurazione che il codice. AtroCore ne è un esempio. È concesso in licenza secondo GPLv3, consente agli amministratori di creare entità e relazioni dal pannello di amministrazione, espone un'API REST e supporta importazione ed esportazione per qualsiasi entità, comprese quelle appena create. La gestione delle informazioni di prodotto e la gestione degli asset digitali funzionano come moduli nella stessa istanza, quindi i prodotti, gli asset e altri dati anagrafici condividono un modello.
I nostri clienti si rivolgono a noi con un punto di partenza familiare. Un produttore mantiene i dati tecnici dei prodotti in ERP, i testi di marketing in fogli di calcolo, le immagini su un file server e i dati di classificazione in un altro strumento ancora. Ogni aggiornamento di catalogo significa raccogliere dati manualmente e verificarli via email. In questi progetti, configuriamo un modello di coesistenza: l'ERP rimane il sistema principale per prezzi, stock, tempi di consegna e campi rilevanti per l'ordine, mentre AtroCore diventa il sistema principale per descrizioni, classificazione, asset e attributi specifici del canale. Le esportazioni verso negozi e partner vengono eseguite da record convalidati. Il cambio pratico è che un attributo mancante appare come una regola fallita su un dashboard prima che un cliente la trovi in un catalogo.
Nei progetti che abbiamo implementato per produttori di attrezzature, i requisiti di informazione dell'EU Data Act sono diventati attributi di prodotto ordinari: tipi di dati generati, volume previsto, frequenza di raccolta e il metodo di accesso. I responsabili di prodotto li mantengono nello stesso record delle specifiche tecniche e una regola di validazione blocca la pubblicazione di un prodotto connesso mentre questi campi sono vuoti. La revisione legale avviene su un record e le informazioni raggiungono la pagina del prodotto e la documentazione dalla stessa fonte.
Open source sposta parte del lavoro su di te. Qualcuno deve possedere la configurazione e pianificare gli upgrade. Le aziende senza un proprietario dati interno di solito hanno bisogno di un partner di implementazione o del supporto del vendor. Il beneficio è che la piattaforma si adatta al modello di business e il percorso di uscita è aperto per design.
Una sequenza di rollout che regge
Inizia con un dominio che ha un dolore visibile e un proprietario chiaro. I dati dei prodotti nella manifattura e i dati dei fornitori negli approvvigionamenti sono candidati tipici. Mappa quale sistema comanda per ogni attributo prima di configurare nulla, perché questo documento risolve più dispute che qualsiasi funzionalità.
Connetti prima i sistemi sorgente principali, poi i canali di consumo. Metti in atto le regole di validazione prima della prima esportazione, in modo che i dati scadenti non raggiungono mai un cliente attraverso la nuova piattaforma. Aggiungi l'arricchimento AI solo dopo che i flag di provenienza e i workflow di revisione funzionano, e dai all'agente il suo ruolo ristretto fin dal primo giorno.
Espandi al dominio successivo una volta che il primo funziona senza workaround manuali per un intero ciclo di rilascio. Questo è il segnale che il modello, la proprietà e le integrazioni reggono. Ogni nuovo dominio allora riusa la stessa governance, ovvero dove una piattaforma unificata di gestione dati inizia a ripagare lo sforzo.