

Points clés à retenir
- Une plateforme de gestion des données unifiées conserve la version officielle des données opérationnelles (produits, clients, fournisseurs, actifs, données de référence) dans un modèle gouverné unique. Elle les synchronise vers chaque système qui en a besoin. Les plateformes analytiques consomment ces données. Elles ne les remplacent pas.
- L'IA a augmenté le coût des mauvaises données. Gartner s'attend à ce que les organisations abandonnent 60 % des projets IA qui manquent de données prêtes pour l'IA d'ici 2026.
- La loi européenne sur les données a transformé l'export de données et le changement de prestataire en obligations légales pour les fournisseurs cloud et SaaS. Le verrouillage est maintenant un sujet d'approvisionnement et de conformité.
- La plupart des projets échoués échouent sur la responsabilité et le périmètre. Des propriétaires d'attributs mal définis et des migrations de type « tout à la fois » causent plus de dégâts que les fonctionnalités manquantes.
- Testez toute plateforme avec vos données réelles les plus complexes et une export complète avant de signer.
Ce qu'une plateforme de gestion des données unifiées unifie réellement
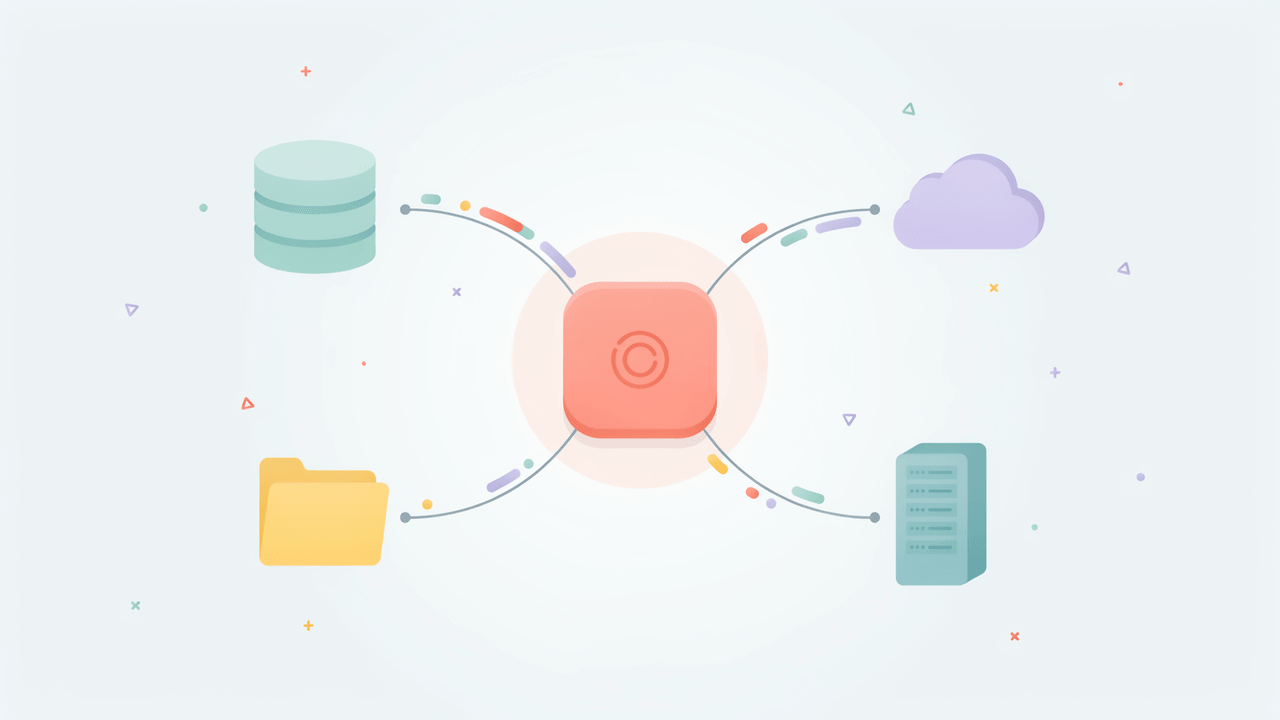
Le terme est souvent galvaudé. Les éditeurs l'attachent à des data warehouses, lakehouses, suites de gestion des données maitresses et hubs d'intégration. Cet article utilise le sens opérationnel : une plateforme unique où une organisation définit ses entités clés, stocke la version correcte de chaque enregistrement, vérifie sa qualité et la distribue vers ERP, e-commerce, CRM, places de marché et portails partenaires.
Un périmètre type couvre les données maitresses pour les produits, clients, fournisseurs et sites. Il ajoute les informations produit avec des attributs spécifiques par canal, les actifs numériques liés aux enregistrements qu'ils décrivent, et les données de référence telles que les unités de mesure, les codes pays et les systèmes de classification comme ETIM, ECLASS, UNSPSC ou GS1 GPC. Au-dessus se situe une couche d'intégration (imports, exports, APIs, synchronisation programmée) et la gouvernance : rôles, permissions au niveau des champs, workflows et un historique complet des modifications.
La pile analytique se trouve en aval. Un data lake répond à la question « qu'est-ce qui s'est passé le trimestre dernier ? ». Une plateforme de gestion des données unifiées répond à la question « quel est le poids correct de l'article 4711 en ce moment et qui l'a changé mardi ? ». Les entreprises qui confondent les deux construisent souvent un excellent warehouse et envoient quand même trois descriptions de produit contradictoires à trois canaux. Les données n'ont jamais été corrigées à la source.
Pourquoi 2026 a changé les exigences
L'IA a transformé la qualité des données en ligne budgétaire
Une enquête Gartner a révélé que 63 % des organisations manquent soit des bonnes pratiques de gestion des données pour l'IA, soit ne savent pas si elles les ont. Sur cette base, Gartner prédit que les organisations abandonneront 60 % des projets IA non soutenus par des données prêtes pour l'IA d'ici 2026. Gartner affirme également que la gestion des données traditionnelle est trop lente et trop rigide pour les équipes IA, que les données s'entassent souvent dans des silos à travers de nombreux systèmes, et que la plupart des organisations manquent des métadonnées pour évaluer si leurs données sont prêtes. Sa recommandation est de passer des métadonnées de la documentation passive à l'utilisation active et automatisée.
« Si les données présentent des problèmes, alors les données ne sont pas prêtes pour l'IA. » Gartner, 2025
En pratique, l'IA a besoin de contexte pour chaque enregistrement : la source, la dernière modification, l'état de validation et la complétude par canal. Une plateforme qui stocke cela comme des métadonnées interrogeables donne à un pipeline IA un simple filtre. Seuls les enregistrements qui ont passé la validation entrent dans les jeux d'entraînement ou les index de récupération. Sans ces métadonnées, chaque projet IA reconstruit le même filtre à la main. Et puis le projet suivant le refait.
Les agents réécrivent les données
La première vague d'IA lisait les données. Les agents changent la direction du flux. Un agent qui enrichit les descriptions de produits, mappe les attributs des fournisseurs ou corrige les unités manquantes écrit dans les données maitresses. Cela fait de la gestion des accès une question de plateforme de données.
Gartner prédit que plus de 40 % des projets IA à agents seront annulés d'ici la fin de 2027, citant l'augmentation des coûts, la valeur commerciale peu claire et les contrôles de risque inadéquats. Le même communiqué note que l'intégration d'agents dans les systèmes hérités est techniquement complexe et nécessite souvent des modifications coûteuses.
Les contrôles de risque qu'un agent doit avoir sont pour la plupart des fonctionnalités ordinaires de plateforme de données. Les utilisateurs machines ont besoin de leurs propres rôles. Les droits d'écriture doivent être limités à des champs spécifiques. Chaque modification a besoin d'une version et d'un moyen de la restaurer. Les valeurs générées doivent porter un drapeau pour que les relecteurs et les systèmes en aval sachent d'où elles viennent, et un workflow de révision doit s'interposer entre l'agent et la publication. Si la plateforme ne peut pas le faire, le choix se réduit à un accès complet en écriture ou aucun. L'accès complet échoue la revue de risque. Aucun accès termine le cas d'utilisation.
La loi européenne sur les données a rendu la portabilité exécutoire
La loi sur les données s'applique depuis le 12 septembre 2025. Deux parties comptent pour quiconque achète ou gère une plateforme de gestion des données unifiées.
Premièrement, les prestataires de services de traitement des données doivent éliminer les obstacles au changement de fournisseur. Les prestataires SaaS et PaaS doivent proposer des interfaces ouvertes et, au minimum, exporter les données des clients dans un format couramment utilisé et lisible par machine. Les frais de changement, y compris les frais d'accès aux données, disparaissent complètement à partir du 12 janvier 2027. Les conditions de sortie dans les contrats de plateforme sont maintenant quelque chose que les acheteurs peuvent et doivent négocier en détail.
Deuxièmement, les fabricants de produits connectés deviennent des détenteurs de données. Ils doivent indiquer aux utilisateurs quelles données un produit génère, en quel volume et à quelle fréquence de collecte, et le champ d'application comprend les métadonnées pertinentes. Ces informations appartiennent au produit. Elles se trouvent naturellement à côté des dimensions, certifications, listes de pièces détachées et conditions de garantie dans l'enregistrement maitresse du produit. Les entreprises qui les gardent dans une feuille de calcul juridique séparée finissent par deux versions après la première révision du produit.
La loi sur les données définit également des garanties contre l'accès abusif par les autorités gouvernementales non-UE aux données non personnelles détenues dans l'UE. Pour certains secteurs, cela transforme le choix du lieu d'hébergement et les options d'auto-hébergement, passant de la préférence informatique à un critère de sélection.
Les risques qui apparaissent dans les vrais projets
Les lacunes fonctionnelles tuent rarement un projet de gestion des données unifiées. Les problèmes suivants le font, et la plupart d'entre eux sont visibles avant la signature du contrat.
Un modèle de données que l'éditeur contrôle
Beaucoup de suites livrent un schéma fixe avec des points d'extension. Cela fonctionne jusqu'à ce que le métier change. Un fabricant ajoute une activité de services et a besoin de contrats liés aux unités installées. Une réglementation ajoute des champs de durabilité. Si chaque modification nécessite une version de l'éditeur ou du code personnalisé qui se casse à la mise à jour, la plateforme devient lentement le prochain système hérité.
Le test est simple. Demandez à l'éditeur d'ajouter une nouvelle entité avec des relations à deux entités existantes, pendant la démo, par la configuration uniquement. Puis demandez comment ce changement survit à la prochaine mise à jour.
La migration de type « tout à la fois »
Les projets qui essaient de déplacer chaque domaine en même temps ont tendance à s'enliser dans la phase de mappage des données. Chaque système source a sa propre interprétation d'« produit », de « variante » ou de « client », et résoudre tous ces cas en parallèle surcharge les quelques personnes qui comprennent les données. Un déploiement domaine par domaine livre de la valeur plus tôt et expose les erreurs de modélisation quand elles sont bon marché à corriger.
Personne ne possède l'attribut
Une plateforme peut appliquer des règles. Elle ne peut pas décider qui est responsable du poids net, de la classification des risques, du numéro de tarif douanier ou de la description marketing. Quand la responsabilité reste vague, les gens corrigent les données dans le système qui est ouvert sur leur écran, et la plateforme devient une copie de plus. Assignez un propriétaire par groupe d'attributs, enregistrez-le dans la plateforme, et routez les défauts de validation vers cette personne.
Une plateforme de gestion des données unifiées centralise la responsabilité. Si la responsabilité reste dispersée, les données la suivront.
La prolifération d'intégrations
Les intégrations point à point croissent quadratiquement. Huit systèmes connectés directement ont besoin de jusqu'à 28 interfaces. Les mêmes huit systèmes connectés via une plateforme centrale en ont besoin de huit. L'arithmétique est évidente, mais de nombreuses entreprises ajoutent encore une connexion directe ERP vers boutique « juste pour les prix » et finissent avec une deuxième source de vérité cachée. Décidez par attribut quel système est maître, et routez tout le reste via la plateforme.
La tarification qui pénalise la croissance
Certains modèles de tarification évoluent avec le nombre d'enregistrements, de SKU, de canaux ou d'appels API. Les coûts semblent corrects au lancement et croissent avec chaque nouvelle ligne de produits ou marché. Modélisez le prix pour trois ans de croissance attendue avant de signer, y compris le coût des environnements supplémentaires dont vous aurez besoin pour les tests.
Le contenu généré par l'IA sans provenance
Les descriptions générées et les valeurs d'attributs peuvent entrer dans les enregistrements de référence rapidement et silencieusement. Six mois plus tard, personne ne sait quelles valeurs une personne a vérifiées. Stockez la provenance par valeur, au minimum « manuel », « importé », « traduit » et « généré », et gardez les valeurs générées hors des champs réglementés tels que les données de sécurité jusqu'à ce que quelqu'un les approuve.
Les choix d'architecture et leurs compromis
Il n'y a pas une seule architecture correcte. Chaque option déplace l'effort ailleurs.
Un hub central stocke et crée les données en un seul endroit et les pousse vers l'extérieur. Cela donne la responsabilité la plus claire et la piste d'audit la plus simple. Le coût est l'effort de migration et la nécessité de se mettre d'accord sur un modèle unique entre les départements.
Un modèle de coexistence permet aux systèmes sources de continuer à créer certains attributs tandis que la plateforme les consolide, les enrichit et les redistribue. ERP conserve les prix et le stock ; la plateforme possède les contenus marketing et la classification. C'est le modèle le plus courant en fabrication car il n'exige pas de remplacer les processus ERP. Il nécessite des règles précises sur quel système domine pour chaque attribut, sinon deux systèmes se remplaceront mutuellement.
Un data fabric laisse les données dans leurs sources et fournit une vue virtuelle et unifiée au-dessus. C'est rapide à démarrer et fonctionne bien pour l'accès en lecture et l'analytique. C'est faible pour la création et l'application de la qualité, car il n'y a pas de place centrale où un enregistrement est corrigé.
Un data mesh attribue la responsabilité des données aux domaines métier qui publient les données en tant que produits. Cela évolue bien la responsabilité dans les grandes organisations avec des équipes matures. Dans les entreprises de taille moyenne, cela s'enlise souvent car les domaines manquent de personnes pour gérer leurs propres produits de données.
De nombreuses organisations en combinent plusieurs. Un hub de coexistence pour les données maitresses avec un fabric pour l'accès analytique est une configuration courante et viable.
Comment évaluer une plateforme de gestion des données unifiées
Les démos utilisent des données d'exemple propres. Votre évaluation ne devrait pas. Menez une preuve de concept avec un export réel de votre source la plus complexe et vérifiez ce qui suit :
- Les changements de modèle par la configuration.
Ajoutez une entité, une relation et un ensemble d'attributs sans code, puis confirmez que le changement survit à une mise à jour. - L'export complet.
Exportez tous les enregistrements, actifs, relations et l'historique des modifications en format ouvert. Selon la loi sur les données, c'est le minimum, donc demandez comment cela fonctionne en pratique et combien de temps cela prend. - La couverture API.
Chaque objet et action disponible dans l'interface utilisateur doit être disponible via l'API, y compris les métadonnées de configuration. - Les permissions au niveau des champs et les utilisateurs machines.
Créez un rôle restreint pour un agent IA ou une intégration et confirmez qu'il ne peut écrire que dans les champs prévus. - Les règles de validation et de complétude.
Définissez la complétude spécifique par canal et vérifiez que les enregistrements qui échouent sont bloqués de l'export, avec une raison claire. - L'historique et la restauration.
Changez une valeur, découvrez qui l'a changée et à partir de quelle source, puis restaurez la version précédente. - Les options d'hébergement et de licence.
Clarifiez les régions d'hébergement et les options d'auto-hébergement. Demandez ce qui se passe à vos données et votre configuration si le contrat se termine.
Notez les lacunes par effort pour les combler, pas par nombre. Un chemin d'export manquant peut surpasser dix fonctionnalités de commodité manquantes.
Où s'inscrit une plateforme open source configurable
Les plateformes open source configurables répondent directement aux risques de modèle de données et de verrouillage, car le client contrôle la configuration et le code. AtroCore en est un exemple. Elle est sous licence GPLv3, permet aux administrateurs de créer des entités et relations depuis le panneau d'administration, expose une API REST et supporte l'import et l'export pour toute entité, y compris celles nouvellement créées. La gestion des informations produit et la gestion des actifs numériques fonctionnent en tant que modules dans la même instance, donc les produits, les actifs et les autres données maitresses partagent un modèle unique.
Nos clients nous contactent avec un point de départ familier. Un fabricant garde les données produit techniques dans ERP, les textes marketing dans des feuilles de calcul, les images sur un serveur de fichiers et les données de classification dans un autre outil encore. Chaque mise à jour de catalogue signifie collecter les données à la main et les vérifier par email. Dans ces projets, nous mettons en place un modèle de coexistence : ERP reste le système maître pour les prix, le stock, les délais de livraison et les champs pertinents pour les commandes, tandis que AtroCore devient le système maître pour les descriptions, la classification, les actifs et les attributs spécifiques par canal. Les exports vers les boutiques et les partenaires s'exécutent à partir d'enregistrements validés. Le changement pratique est qu'un attribut manquant s'affiche comme une règle échouée sur un tableau de bord avant qu'un client ne la trouve dans un catalogue.
Dans les projets que nous avons mis en œuvre pour les fabricants d'équipements, les exigences d'information de la loi sur les données sont devenues des attributs produit ordinaires : types de données générés, volume attendu, fréquence de collecte et méthode d'accès. Les chefs de produit les maintiennent dans le même enregistrement que les spécifications techniques, et une règle de validation bloque la publication d'un produit connecté tant que ces champs sont vides. La revue juridique se fait sur un enregistrement, et l'information atteint la page produit et la documentation à partir de la même source.
L'open source déplace certains travaux vers vous. Quelqu'un doit posséder la configuration et planifier les mises à jour. Les entreprises sans propriétaire de données interne ont généralement besoin d'un partenaire d'implémentation ou du support du fournisseur. Le bénéfice est que la plateforme s'adapte au modèle métier, et le chemin de sortie est ouvert par conception.
Une séquence de déploiement qui tient bon
Commencez par un domaine qui a une douleur visible et un propriétaire clair. Les données produit en fabrication et les données fournisseur en approvisionnement sont des candidats typiques. Cartographiez quel système domine pour chaque attribut avant de configurer quoi que ce soit, car ce document résout plus de disputes que n'importe quelle fonctionnalité.
Connectez d'abord les systèmes sources maîtres, puis les canaux consommateurs. Mettez en place les règles de validation avant le premier export, pour que les mauvaises données n'atteignent jamais un client via la nouvelle plateforme. Ajoutez l'enrichissement IA uniquement après que les drapeaux de provenance et les workflows de révision fonctionnent, et donnez à l'agent son propre rôle restreint dès le départ.
Développez vers le domaine suivant une fois que le premier fonctionne sans contournements manuels pour un cycle de libération complet. C'est le signal que le modèle, la responsabilité et les intégrations tiennent. Chaque nouveau domaine réutilise ensuite la même gouvernance, c'est là qu'une plateforme de gestion des données unifiées commence à rembourser l'effort.