

Die wichtigsten Erkenntnisse
- Eine einheitliche Datenmanagement-Plattform verwaltet die verbindliche Version operativer Daten (Produkte, Kunden, Lieferanten, Assets, Referenzdaten) in einem kontrollierten Datenmodell. Sie synchronisiert diese Daten an alle Systeme, die sie benötigen. Analytics-Plattformen nutzen diese Daten. Sie ersetzen sie nicht.
- AI hat den Preis schlechter Daten erhöht. Gartner geht davon aus, dass Unternehmen bis 2026 60 % der AI-Projekte einstellen, denen AI-ready Data fehlt.
- Das EU-Datengesetz machte Datenexport und Anbieterwechsel zur Rechtsplicht für Cloud- und SaaS-Anbieter. Lock-in ist nun ein Beschaffungs- und Compliance-Thema.
- Die meisten gescheiterten Projekte scheitern an Verantwortung und Umfang. Unklare Attribut-Eigentümer und Big-Bang-Migrationen verursachen mehr Schaden als fehlende Funktionen.
- Testen Sie jede Plattform mit Ihren messiest Real Data und einem vollständigen Export, bevor Sie unterschreiben.
Was eine einheitliche Datenmanagement-Plattform wirklich vereinheitlicht
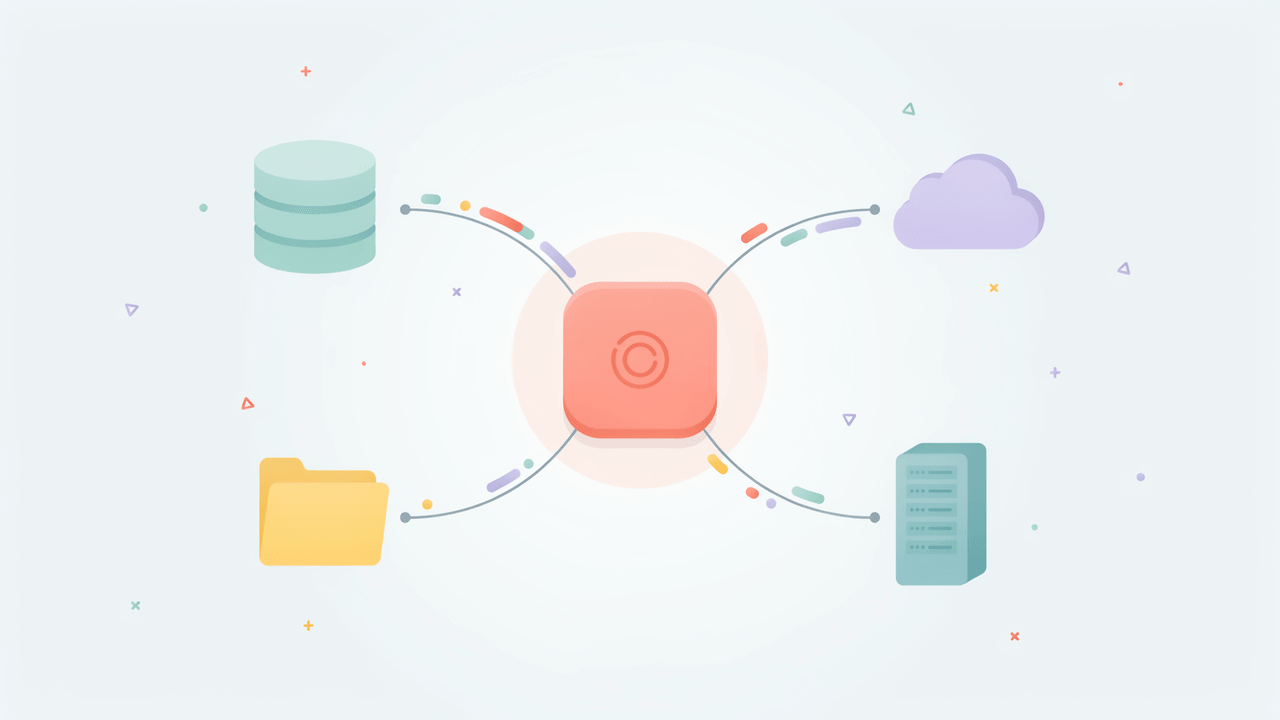
Der Begriff wird überstrapaziert. Anbieter verbinden ihn mit Data Warehouses, Lakehouses, MDM-Suites und Integrationshubs. Dieser Artikel verwendet die operative Bedeutung: eine Plattform, auf der eine Organisation ihre Kernentitäten definiert, die korrekte Version jedes Datensatzes speichert, dessen Qualität prüft und ihn an ERP, E-Commerce, CRM, Marktplätze und Partner-Portale verteilt.
Ein typischer Umfang umfasst Stammdaten für Produkte, Kunden, Lieferanten und Standorte. Hinzu kommen Produktinformationen mit kanalspezifischen Attributen, digitale Assets, die mit den Datensätzen verknüpft sind, die sie beschreiben, sowie Referenzdaten wie Maßeinheiten, Ländercodes und Klassifizierungssysteme wie ETIM, ECLASS, UNSPSC oder GS1 GPC. Darüber liegt eine Integrationssicht (Import-Feeds, Export-Feeds, APIs, geplante Synchronisierung) und Governance: Rollen, Berechtigungen auf Feldebene, Workflows und eine vollständige Änderungshistorie.
Der Analytical Stack sitzt nachgelagert. Ein Lakehouse beantwortet die Frage, was letztes Quartal passiert ist. Eine einheitliche Datenmanagement-Plattform beantwortet die Frage, wie viel der korrekte Gewicht des Artikels 4711 genau ist und wer ihn Dienstag geändert hat. Unternehmen, die beide verwechseln, bauen oft ein ausgezeichnetes Warehouse und versenden trotzdem drei unterschiedliche Produktbeschreibungen an drei Kanäle. Die Daten wurden nie an der Quelle korrigiert.
Warum 2026 die Anforderungen geändert hat
AI machte Datenqualität zur Haushaltsposition
Eine Gartner-Umfrage ergab, dass 63 % der Unternehmen entweder nicht über die richtigen Datenmanagement-Praktiken für AI verfügen oder nicht wissen, ob sie sie haben. Darauf basierend prognostiziert Gartner, dass Unternehmen bis 2026 60 % der AI-Projekte einstellen werden, die nicht durch AI-ready Data unterstützt werden. Gartner stellt auch fest, dass traditionelles Datenmanagement für AI-Teams zu langsam und zu starr ist, dass Daten oft in Silos auf vielen Systemen sitzen und dass die meisten Organisationen die Metadaten nicht haben, um zu beurteilen, ob ihre Daten überhaupt bereit sind. Seine Empfehlung ist, Metadaten von passiver Dokumentation zu aktiver, automatisierter Nutzung zu bewegen.
„Wenn die Daten Probleme haben, dann sind die Daten nicht für AI bereit." Gartner, 2025
In der Praxis benötigt AI Kontext für jeden Datensatz: die Quelle, die letzte Änderung, den Validierungsstatus und die Vollständigkeit pro Kanal. Eine Plattform, die dies als abfragbare Metadaten speichert, gibt einer AI-Pipeline einen einfachen Filter. Nur Datensätze, die die Validierung bestanden haben, gehen in Trainingssets oder Retrieval-Indizes. Ohne diese Metadaten baut jedes AI-Projekt denselben Filter von Hand auf. Und dann macht das nächste Projekt dasselbe wieder.
Agenten schreiben Daten zurück
Die erste Welle von AI las Daten. Agenten ändern die Richtung des Datenflusses. Ein Agent, der Produktbeschreibungen erweitert, Lieferantenattribute abbildet oder fehlende Einheiten behebt, schreibt in Stammdaten. Das macht Zugriffskontrolle zu einer Datenplattform-Frage.
Gartner prognostiziert, dass über 40 % der agentic AI-Projekte bis Ende 2027 abgebrochen werden, aufgrund von eskalierenden Kosten, unklar definiertem Geschäftswert und unzureichenden Risikokontrollen. Die gleiche Mitteilung stellt fest, dass die Integration von Agenten in Legacy-Systeme technisch komplex ist und oft teure Änderungen erfordert.
Die Risikokontrollen, die ein Agent benötigt, sind größtenteils gewöhnliche Datenplattform-Funktionen. Maschinelle Benutzer benötigen ihre eigenen Rollen. Schreibrechte sollten auf bestimmte Felder beschränkt sein. Jede Änderung muss eine Version haben und eine Möglichkeit zum Rollback. Generierte Werte sollten ein Flag tragen, damit Prüfer und nachgelagerte Systeme wissen, woher sie stammen, und ein Review-Workflow sollte zwischen dem Agent und der Veröffentlichung sitzen. Wenn die Plattform dies nicht kann, verengt sich die Auswahl auf vollständigen Schreibzugriff oder nichts. Vollständiger Zugriff scheitert die Risikoprüfung. Kein Zugriff beendet den Use Case.
Das EU-Datengesetz machte Portabilität verbindlich
Das Datengesetz gilt seit 12. September 2025. Zwei Teile sind wichtig für alle, die eine einheitliche Datenmanagement-Plattform kaufen oder betreiben.
Zunächst müssen Anbieter von Datenverarbeitungsdiensten Hindernisse für einen Anbieterwechsel beseitigen. SaaS- und PaaS-Anbieter müssen offene Schnittstellen bieten und mindestens Kundendaten in einem häufig verwendeten, maschinenlesbaren Format exportieren. Wechselgebühren, einschließlich Daten-Egress-Gebühren, entfallen vollständig ab 12. Januar 2027. Exit-Bedingungen in Plattformverträgen sind nun etwas, das Käufer verhandeln können und sollten.
Zweitens werden Hersteller verbundener Produkte zu Datenhältern. Sie müssen Benutzern mitteilen, welche Daten ein Produkt erzeugt, in welchem Volumen und in welcher Erfassungshäufigkeit, und der Umfang umfasst relevante Metadaten. Diese Informationen gehören zum Produkt. Sie sitzen natürlich neben Abmessungen, Zertifizierungen, Ersatzteilistenen und Garantiebedingungen im Produkt-Masterdatensatz. Unternehmen, die diese in einer separaten Rechtsschutz-Tabelle aufbewahren, enden nach der ersten Produktrevision mit zwei Versionen.
Das Datengesetz setzt auch Schutzmaßnahmen gegen rechtswidrige Zugriffe durch nicht-EU-Regierungsstellen auf nicht-personenbezogene Daten, die in der EU gespeichert sind. Für einige Branchen wird die Hosting-Location und Self-Hosting-Optionen von IT-Vorlieben zu Auswahlkriterium.
Die Risiken, die in echten Projekten auftauchen
Funktionslücken töten ein einheitliches Datenmanagement-Projekt selten. Die folgenden Probleme tun es, und die meisten sind vor Vertragsabschluss sichtbar.
Ein Datenmodell, das der Anbieter besitzt
Viele Suites haben ein festes Schema mit Erweiterungspunkten. Das funktioniert, bis sich das Geschäft ändert. Ein Hersteller fügt ein Service-Geschäft hinzu und benötigt Verträge, die mit installierten Einheiten verknüpft sind. Eine Verordnung fügt Nachhaltigkeitsfelder hinzu. Wenn jede Änderung ein Vendor-Release oder benutzerdefinierten Code benötigt, der bei Upgrades bricht, wird die Plattform langsam zum nächsten Legacy-System.
Der Test ist einfach. Bitten Sie den Anbieter, während der Demo eine neue Entität mit Relationen zu zwei vorhandenen hinzuzufügen, nur durch Konfiguration. Fragen Sie dann, wie diese Änderung das nächste Upgrade überlebt.
Die Big-Bang-Migration
Projekte, die versuchen, alle Domänen gleichzeitig zu verschieben, neigen dazu, in der Daten-Mapping-Phase stecken zu bleiben. Jedes Quellsystem hat seine eigene Interpretation von „Produkt", „Variante" oder „Kunde", und die gleichzeitige Lösung aller überfordert die wenigen Personen, die die Daten verstehen. Ein Domain-für-Domain-Rollout liefert schneller Wert und offenbart Modellierungsfehler, während sie noch billig zu beheben sind.
Niemand besitzt das Attribut
Eine Plattform kann Regeln durchsetzen. Sie kann nicht entscheiden, wer für das Nettogewicht, die Hazmat-Klassifizierung, die Zolltariffnummer oder die Marketing-Beschreibung zuständig ist. Wenn die Verantwortung vage bleibt, korrigieren Menschen Daten in dem System, das gerade offen ist, und die Plattform wird zu einer weiteren Kopie. Weisen Sie pro Attributgruppe einen Eigentümer zu, halten Sie ihn in der Plattform fest und leiten Sie Validierungsfehler an diese Person weiter.
Eine einheitliche Datenmanagement-Plattform zentralisiert Verantwortung. Wenn die Verantwortung zerstreut bleibt, werden es die Daten auch.
Integrations-Chaos
Point-to-Point-Integrationen wachsen quadratisch. Acht direkt verbundene Systeme benötigen bis zu 28 Schnittstellen. Die gleichen acht Systeme, die über eine zentrale Plattform verbunden sind, benötigen acht. Die Arithmetik ist offensichtlich, aber viele Unternehmen fügen immer noch eine direkte ERP-zu-Shop-Verbindung „nur für Preise" hinzu und enden mit einer verborgenen zweiten Wahrheitsquelle. Entscheiden Sie pro Attribut, welches System führt, und leiten Sie alles andere durch die Plattform.
Preismodelle, die Wachstum bestrafen
Einige Preismodelle skalieren mit Datensätzen, SKUs, Kanälen oder API-Aufrufen. Die Kosten sehen bei der Aktivierung gut aus und wachsen mit jeder neuen Produktlinie oder jedem neuen Markt. Modellieren Sie den Preis für drei Jahre erwartetes Wachstum vor Vertragsunterzeichnung, einschließlich der Kosten für die zusätzlichen Umgebungen, die Sie zum Testen benötigen.
AI-generierte Inhalte ohne Herkunftsangabe
Generierte Beschreibungen und Attributwerte können schnell und still in goldene Datensätze eingehen. Sechs Monate später weiß niemand, welche Werte eine Person geprüft hat. Speichern Sie Herkunft pro Wert, mindestens „manuell", „importiert", „übersetzt" und „generiert", und halten Sie generierte Werte aus regulierten Feldern wie Sicherheitsdaten, bis jemand sie genehmigt.
Architekturoptionen und ihre Kompromisse
Es gibt keine einzige korrekte Architektur. Jede Option verschiebt den Aufwand an einen anderen Ort.
Ein zentraler Hub speichert und erstellt Daten an einem Ort und drückt sie hinaus. Es gibt die klarste Verantwortung und die einfachste Audit-Trail. Die Kosten sind Migrationsbedarf und die Notwendigkeit, sich auf ein Modell über Abteilungen hinweg zu einigen.
Ein Koexistenz-Modell lässt Quellsysteme einige Attribute weiterhin erstellen, während die Plattform sie konsolidiert, bereichert und umverteilt. ERP behält Preise und Lagerbestände; die Plattform besitzt Marketing-Inhalte und Klassifizierung. Dies ist das häufigste Muster in der Fertigung, da es nicht erforderlich ist, ERP-Prozesse zu ersetzen. Es benötigt präzise Regeln darüber, welches System für jedes Attribut führt, oder zwei Systeme werden sich gegenseitig überschreiben.
Ein Data Fabric lässt Daten in ihren Quellen und bietet eine virtuelle, einheitliche Sicht darauf. Es ist schnell zu starten und funktioniert gut für Lesezugriff und Analytics. Es ist schwach bei der Erstellung und Qualitätsdurchsetzung, da es keinen zentralen Ort gibt, an dem ein Datensatz korrigiert wird.
Ein Data Mesh weist Dateneigentümerschaft Geschäftsdomänen zu, die Daten als Produkte veröffentlichen. Es skaliert Verantwortung gut in großen Organisationen mit reifen Teams. In mittelständischen Unternehmen stagniert es oft, weil den Domänen die Personen fehlen, um ihre eigenen Datenprodukte zu betreiben.
Viele Organisationen kombinieren diese. Ein Koexistenz-Hub für Stammdaten mit einem Fabric für analytischen Zugriff ist ein häufiges und funktionierendes Setup.
So evaluieren Sie eine einheitliche Datenmanagement-Plattform
Demos verwenden saubere Beispieldaten. Ihre Evaluierung sollte das nicht. Führen Sie einen Proof of Concept mit einem echten Export aus Ihrer messiest Quelle durch und prüfen Sie Folgendes:
- Modelländerungen durch Konfiguration.
Fügen Sie eine Entität, eine Relation und einen Satz von Attributen ohne Code hinzu, bestätigen Sie dann, dass die Änderung ein Upgrade überlebt. - Vollständiger Export.
Exportieren Sie alle Datensätze, Assets, Relationen und Änderungshistorie in einem offenen Format. Nach dem Datengesetz ist dies das Minimum. Fragen Sie, wie es in der Praxis funktioniert und wie lange es dauert. - API-Abdeckung.
Jedes Objekt und jede Aktion, die in der Benutzeroberfläche verfügbar ist, sollte über die API verfügbar sein, einschließlich Konfigurationsmetadaten. - Berechtigungen auf Feldebene und Maschinenbenutzer.
Erstellen Sie eine eingeschränkte Rolle für einen AI-Agent oder eine Integration und bestätigen Sie, dass er nur die beabsichtigten Felder schreiben kann. - Validierungs- und Vollständigkeitsregeln.
Definieren Sie kanalspezifische Vollständigkeit und stellen Sie sicher, dass fehlerhafte Datensätze vom Export blockiert werden, mit einem klaren Grund. - Verlauf und Rollback.
Ändern Sie einen Wert, ermitteln Sie, wer ihn geändert hat und von welcher Quelle, und stellen Sie die vorherige Version wieder her. - Hosting- und Lizenzierungsoptionen.
Klären Sie Hosting-Regionen und Self-Hosting-Optionen. Fragen Sie, was mit Ihren Daten und der Konfiguration geschieht, wenn der Vertrag endet.
Bewerten Sie die Lücken nach Schließungsaufwand, nicht nach Zahl. Ein fehlender Export-Pfad kann zehn fehlende Komfortfunktionen aufwiegen.
Wo eine konfigurierbare Open-Source-Plattform passt
Konfigurierbare Open-Source-Plattformen adressieren die Datenmodell- und Lock-in-Risiken direkt, da der Kunde beide Konfiguration und Code kontrolliert. AtroCore ist ein Beispiel. Es ist unter GPLv3 lizenziert, lässt Administratoren Entitäten und Relationen vom Admin-Panel erstellen, exponiert eine REST-API und unterstützt Import und Export für jede Entität, einschließlich neu erstellter. Produktinformationsmanagement und Digitalasset-Management laufen als Module in der gleichen Instanz, daher Produkte, Assets und andere Stammdaten teilen ein Modell.
Unsere Kunden wenden sich an uns mit einem vertrauten Ausgangspunkt. Ein Hersteller hält technische Produktdaten in ERP, Marketing-Texte in Tabellen, Bilder auf einem Dateiserver und Klassifizierungsdaten in einem weiteren Tool. Jedes Katalog-Update bedeutet, Daten von Hand zu sammeln und per E-Mail zu prüfen. In diesen Projekten richten wir ein Koexistenz-Modell ein: ERP bleibt das führende System für Preise, Bestand, Lieferzeiten und auftragsbezogene Felder, während AtroCore zum führenden System für Beschreibungen, Klassifizierung, Assets und kanalspezifische Attribute wird. Exporte an Shops und Partner laufen von validierten Datensätzen. Die praktische Änderung ist, dass ein fehlender Attribut vor einem Kunden auf einem Armaturenbrett auftaucht, bevor er ihn in einem Katalog findet.
In Projekten, die wir für Ausrüstungshersteller implementierten, wurden die Datengesetz-Informationsanforderungen zu regelmäßigen Produktattributen: erzeugte Datentypen, erwartetes Volumen, Erfassungshäufigkeit und die Zugriffsmethode. Produktmanager pflegen sie im gleichen Datensatz wie technische Spezifikationen, und eine Validierungsregel blockiert die Veröffentlichung eines verbundenen Produkts, während diese Felder leer sind. Die Rechtsüberprüfung erfolgt auf einem Datensatz, und die Informationen erreichen die Produktseite und die Dokumentation aus der gleichen Quelle.
Open Source verschiebt einige Arbeit zu Ihnen. Jemand muss die Konfiguration besitzen und Upgrades planen. Unternehmen ohne einen internen Dateneigentümer benötigen normalerweise einen Implementierungspartner oder den Support des Anbieter. Der Vorteil ist, dass sich die Plattform dem Geschäftsmodell anpasst, und der Exit-Pfad ist von Natur aus offen.
Eine Rollout-Sequenz, die hält
Beginnen Sie mit einer Domain, die offensichtliche Probleme hat und einen klaren Eigentümer hat. Produktdaten in der Fertigung und Lieferantendaten in der Beschaffung sind typische Kandidaten. Ordnen Sie, welches System für jedes Attribut führt, bevor Sie etwas konfigurieren, da dieses Dokument mehr Disputes löst als jede Funktion.
Verbinden Sie die führenden Quellsysteme zuerst, dann die verbrauchenden Kanäle. Implementieren Sie Validierungsregeln, bevor der erste Export, damit schlechte Daten die Kunden nie durch die neue Plattform erreichen. Fügen Sie AI-Bereicherung nur hinzu, nachdem Herkunftsflags und Review-Workflows funktionieren, und geben Sie dem Agent von Tag eins an seine eigene eingeschränkte Rolle.
Expandieren Sie auf die nächste Domain, sobald die erste ohne manuelle Umgehungen für einen vollständigen Release-Zyklus läuft. Das ist das Signal, dass das Modell, die Verantwortung und die Integrationen halten. Jede neue Domain verwendet dann die gleiche Governance erneut, wo eine einheitliche Datenmanagement-Plattform anfängt, die Anstrengung zurück zu zahlen.